O.C.E.A.N.
LIBRARY
of confidential and privileged information
reactivação para Instável
Sinopse
O.C.E.A.N. LIBRARY of confidential and privileged information transforma um arquivo de documentos da Cambridge Analytica/SCL numa biblioteca, corpus computacional e projecção narrativa. A reactivação de 2026 parte de um esquema de storytelling baseado na Cinderela encontrado no próprio arquivo e coloca em contacto dois corpos de linguagem: os documentos dos seis conjuntos — Bolton, Brasil, Ghana, Iran, Kenya e Malaysia — e duas transmissões portuguesas da Cinderela. O sistema trabalha apenas com linguagem já existente nessas fontes e tenta construir, continuamente, pequenas histórias através de um arco de quatro movimentos: FALL → ACTION → REVERSAL → TRANSFORMATION.
Do leak à biblioteca
O.C.E.A.N. LIBRARY é um projecto iniciado por paula em 2020 durante a divulgação pública de documentos internos da Cambridge Analytica/SCL. À medida que os ficheiros eram disponibilizados organizados por países, paula começou a descarregar, organizar, imprimir e encadernar esse material, preservando a estrutura das pastas digitais.
O resultado foi uma biblioteca física composta por seis volumes — Bolton, Brasil, Ghana, Iran, Kenya e Malaysia — acompanhados por um photozine, materiais de investigação, poster e duas caixas-arquivo. A passagem do ficheiro ao livro deu ao arquivo peso, espessura, escala e presença corporal.
ficheiro → leak → documento impresso → livro → biblioteca
Este arquivo pertence também à história recente da desinformação e das “fake news”. A investigação parlamentar britânica que examinou Cambridge Analytica/SCL decorreu precisamente no quadro do inquérito Disinformation and ‘fake news’, relacionando o uso de dados pessoais e o microtargeting com questões mais amplas sobre campanhas políticas, circulação de informação falsa ou manipulada e construção dirigida de mensagens. O.C.E.A.N. LIBRARY regressa a esse material em 2026 num momento em que a desinformação, a manipulação do espaço informacional e as novas formas de targeting continuam no centro do debate sobre plataformas digitais, inteligência artificial e democracia. Nesse sentido, o projecto não trata “fake news” apenas como conteúdo falso: interroga as infra-estruturas narrativas que tornam uma mensagem direccionável, persuasiva e capaz de circular como uma versão coerente da realidade.
Cinderella was already inside the archive
Entre os documentos encontrava-se um esquema de storytelling baseado na Cinderela. O seu interesse não estava apenas na presença inesperada de um conto de fadas dentro de um arquivo de consultoria política, mas na proposta de tratar a própria forma narrativa como tecnologia: ordenar acontecimentos, estabelecer causa e consequência, introduzir um problema, uma intervenção e uma resolução.
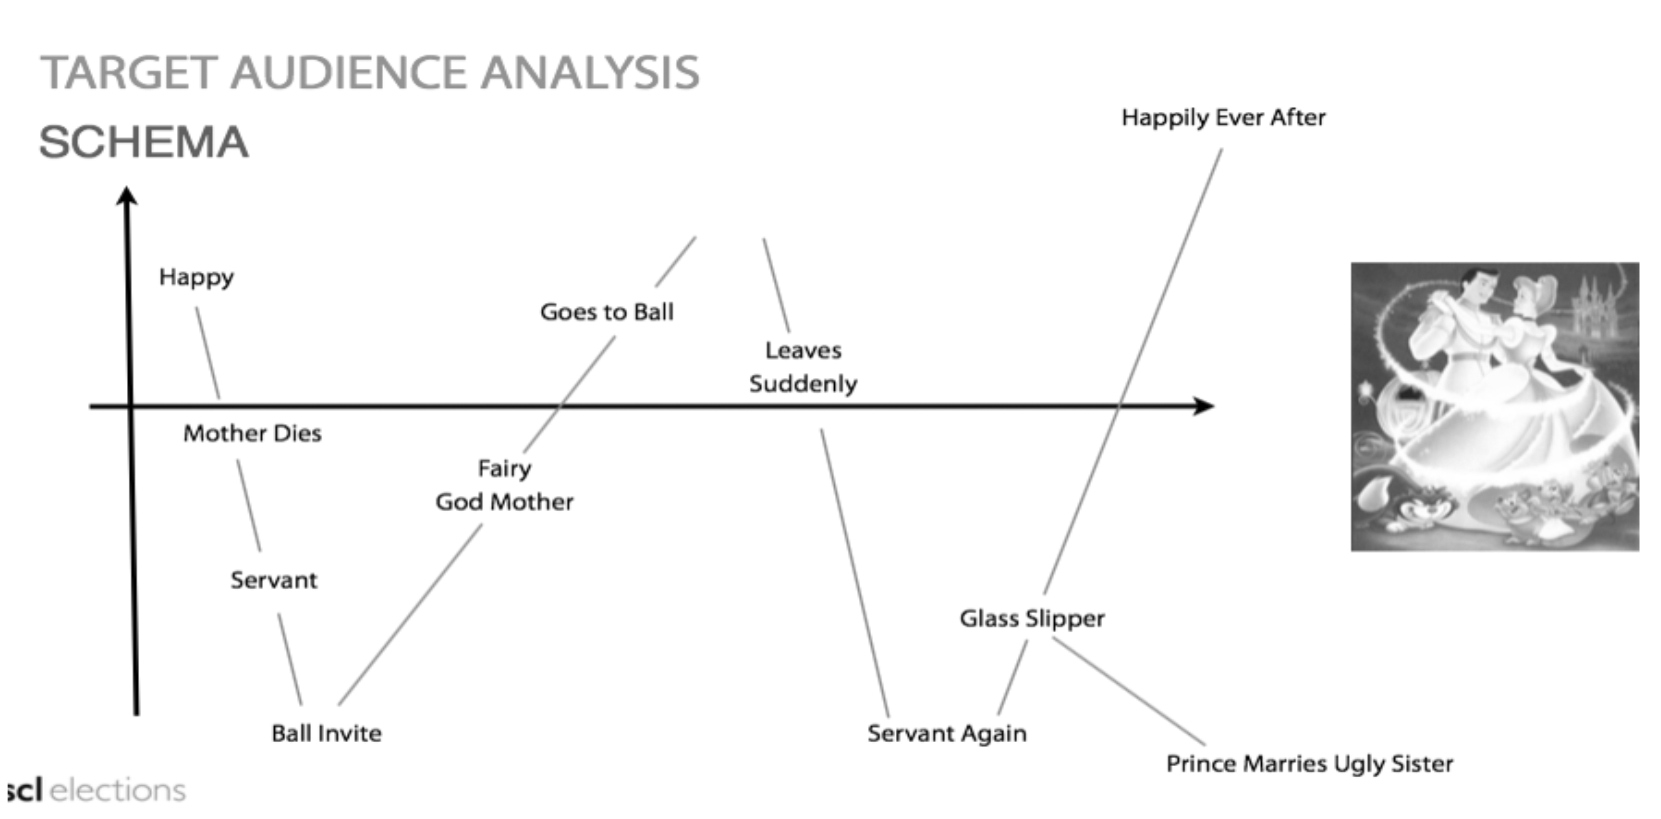
Em 2020, este diagrama foi incorporado materialmente na edição dos volumes. Na reactivação de 2026 para Instável, regressa como estrutura operacional, corpo textual e problema computacional.
Large Language Model / Small Language World
A experiência que conduziu à versão actual começou por perguntar o que aconteceria se uma tecnologia contemporânea de linguagem fosse confrontada com um arquivo extremamente delimitado. A versão expositiva radicaliza essa restrição: o sistema apresentado não é um LLM nem depende de um modelo remoto. Constrói um pequeno mundo linguístico local a partir dos documentos de O.C.E.A.N. LIBRARY e de duas transmissões portuguesas da Cinderela.
O programa não inventa vocabulário para completar as histórias. Selecciona e reorganiza matéria verbal já existente. Em vez da escala potencialmente ilimitada do Large Language Model, trabalha com proveniência, restrição, reutilização e recirculação de um corpus finito.
Em vez de perguntar o que mais pode um Large Language Model produzir, O.C.E.A.N. LIBRARY pergunta o que ainda pode ser produzido a partir daquilo que já existe.
Na versão expositiva, o LLM é retirado da obra. No seu lugar funciona um pequeno aparato editorial computacional: um corpus estruturado e finito, uma gramática narrativa explícita e um motor de composição escrito em JavaScript. O HTML e o CSS constituem o dispositivo de projecção; o código selecciona, relaciona, sequencia e apresenta a matéria textual localmente no browser.
Uma máquina a tentar narrar
O motor compõe primeiro uma micro-história híbrida e distribui-a por quatro ecrãs sucessivos: FALL → ACTION → REVERSAL → TRANSFORMATION. Cada ecrã contém uma única passagem, proveniente do arquivo Cambridge Analytica/SCL ou de uma das transmissões da Cinderela. Cada história combina obrigatoriamente os dois corpos textuais, mas a alternância entre eles não é fixa. A montagem acontece no tempo e depende da memória do espectador entre um quadro e o seguinte.
A projecção torna visível também a operação da máquina. Uma camada de metadata acompanha cada passagem: número da história, posição do ecrã no ciclo, estágio narrativo, tipo de fonte, proveniência documental, sequência e timestamp. Assim, o espectador pode ler simultaneamente a tentativa de narrativa e a forma como o sistema a classifica e documenta.
O objectivo não é produzir uma narrativa perfeita. Interessa aquilo que acontece no limite entre sentido e falha de sentido: coerência suficiente para que uma transformação improvável possa ter consequências. Depois de TRANSFORMATION, um intervalo de negro marca o fim de uma história antes de outra começar.
ficheiro → leak → impressão → livro → biblioteca → corpus → modelo narrativo → código → projecção
O espectador encontra, portanto, não uma narrativa acabada, mas uma máquina a tentar narrar.
Instalação proposta
Mesa para a biblioteca — seis volumes, publicações e materiais associados, incluindo as duas caixas-arquivo.
Parede para projecção — superfície livre para a projecção computacional de texto sobre fundo preto.
Poster 90 × 60 cm — idealmente numa segunda parede; se não houver parede disponível, pode permanecer dobrado sobre a mesa da biblioteca.
Requisitos técnicos
Computador Mac ou PC com browser contemporâneo; projector ou ecrã Full HD (1920 × 1080) ou superior; ligação HDMI e adaptador compatível com o computador, se necessário; cabo HDMI; alimentação eléctrica contínua para computador e projector/ecrã.
A versão expositiva funciona localmente e offline, sem API nem ligação à Internet. O computador deve permanecer activo durante o período expositivo, sem entrar automaticamente em repouso e com o protector de ecrã desactivado. O projector abre em browser e funciona em ecrã inteiro.
Investigação / contexto
O.C.E.A.N. LIBRARY of confidential and privileged information é um projecto iniciado por paula em 2020, na sequência da divulgação pública de documentos internos da Cambridge Analytica, empresa de análise de dados e consultoria política que se tornou central no debate internacional sobre dados pessoais, profiling, microtargeting e influência política através das redes sociais.
O título remete para OCEAN, acrónimo utilizado em psicometria para designar cinco grandes traços de personalidade — Openness, Conscientiousness, Extraversion, Agreeableness e Neuroticism. O modelo não foi inventado pela Cambridge Analytica, mas ficou associado à controvérsia em torno da empresa através da utilização e promoção de métodos que procuravam relacionar dados pessoais e comportamentais com perfis psicológicos e adaptar mensagens a segmentos específicos.
No contexto das metodologias desenvolvidas pela Cambridge Analytica e SCL, análise de dados, profiling, segmentação de públicos, investigação comportamental e construção de mensagens integravam estratégias destinadas a identificar audiências e intervir sobre atitudes e comportamentos. A investigação parlamentar britânica examinou estas práticas no âmbito de um inquérito intitulado Disinformation and ‘fake news’, articulando Cambridge Analytica, data targeting e microtargeting com questões mais vastas sobre campanhas políticas, plataformas digitais, desinformação e circulação de conteúdos falsos ou manipulados. O próprio relatório final assinala a ambiguidade adquirida pela expressão “fake news” e adopta “disinformation” para designar a criação e partilha deliberada de informação falsa ou manipulada destinada a enganar ou induzir em erro.
Em 2018, investigações jornalísticas, regulatórias e parlamentares e testemunhos de antigos colaboradores expuseram práticas relacionadas com a recolha e utilização de dados de milhões de utilizadores do Facebook e com a aplicação de análise de dados e comunicação dirigida a contextos políticos. A investigação do Information Commissioner’s Office britânico tornou o caso parte de uma discussão mais ampla sobre processamento invisível de dados pessoais, profiling e microtargeting político.
O Parlamento britânico recebeu e publicou documentação e testemunhos de antigos colaboradores, incluindo Christopher Wylie e Brittany Kaiser. Entre os materiais submetidos por Kaiser encontravam-se uma declaração escrita, emails e documentação relativa a psychographic targeting. A investigação parlamentar analisou também a relação entre Cambridge Analytica, SCL, Facebook, Global Science Research e outras entidades envolvidas no ecossistema de data analytics e campanhas políticas.
Em 2020, através de Hindsight Files, começou a ser disponibilizado online um vasto conjunto de documentos internos provenientes de materiais conservados por Brittany Kaiser. Foi esta divulgação, organizada por países, que forneceu o arquivo digital a partir do qual O.C.E.A.N. LIBRARY foi construída.
UK Parliament — Digital, Culture, Media and Sport Committee, Disinformation and ‘fake news’: Final Report
Information Commissioner’s Office — Cambridge Analytica investigation
UK Parliament — evidence submitted to the inquiry, including Brittany Kaiser and Christopher Wylie
European Commission — countering information manipulation and disinformation